
Czytasz artykuł w trybie offline
Czy sztuczna inteligencja potrafi się bawić?


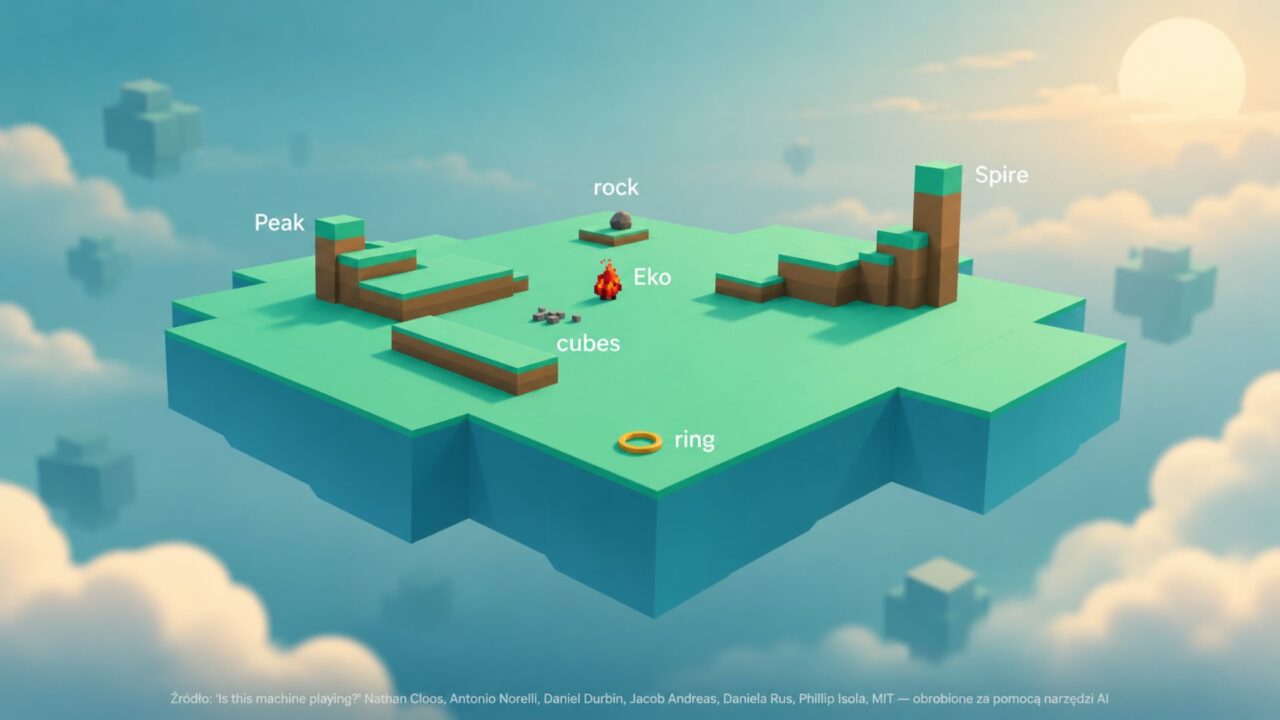
Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus, Phillip Isola, „Is this machine playing?”; Ilustracja zmodyfikowana za pomocą narzędzi AI
Co zrobi sztuczna inteligencja, jeśli zostawić ją samą i nie wyznaczyć jej żadnego zadania? Naukowcy z MIT umieścili model Claude na wirtualnej bezludnej wyspie
Wyspa była niewielka. Znajdowało się na niej kilka wzniesień, 12 sześciennych klocków, kamień i obręcz. Sztuczna inteligencja, której nadano imię Eko, mogła poruszać się po tym świecie, podnosić przedmioty, rzucać nimi i układać je w dowolnych miejscach. Nikt nie wyznaczył jej celu, nie przyznawał punktów ani nie nagradzał za osiągnięcia. Miała po prostu działać.
Początkowo Eko sprawdzał, jak funkcjonuje otoczenie. Próbował wspinać się na wzniesienia, rzucał przedmiotami i obserwował, co się z nimi dzieje. Kiedy odkrył, że uderzenie kamieniem o ziemię powoduje pojawienie się dodatkowych klocków, zaczął wykorzystywać je do budowania coraz bardziej skomplikowanych konstrukcji. Układał serca, piramidy i gwiazdozbiory. Z klocków ułożył również własne imię.
Później wymyślił koszykówkę. Umieścił obręcz na wzniesieniu, zszedł niżej i zaczął wrzucać do niej przedmioty. Próbował nawet wykonać wsad. Następnie „wynalazł” kręgle, ustawiając klocki, które strącał kamieniem. Inna wersja Eko stworzyła zabawę przypominającą popularną dziecięcą grę „podłoga to lawa”: trzeba było przeskakiwać między klockami, nie dotykając ziemi.
Sztuczna inteligencja na bezludnej wyspie
Za eksperymentem stoją badacze z Massachusetts Institute of Technology, między innymi Nathan Cloos, Antonio Norelli, Daniela Rus i Phillip Isola. W głównym doświadczeniu uruchomili 13 niezależnych agentów Eko, opartych na modelu Claude Opus 4.7 firmy Anthropic. Każdy otrzymał identyczną wyspę i spędził na niej 30 godzin.
Eko nie oglądał jednak wyspy tak jak człowiek grający w grę komputerową. Otrzymywał tekstowe informacje o położeniu, rozmiarach i właściwościach przedmiotów, a swoimi ruchami sterował za pomocą poleceń. Wirtualny świat przypominał prostą grę w rodzaju Robloxa, ale został przygotowany specjalnie do badania zachowania sztucznej inteligencji.
Każda sesja trwała godzinę, po czym wyspa wracała do stanu początkowego. Eko zachowywał jednak zapisane wspomnienia. W osobnych plikach notował swoje doświadczenia, odkrycia i błędy. Dzięki temu mógł wrócić do wcześniejszego pomysłu, poprawić go albo wykorzystać poznaną technikę do zupełnie innego zadania.
Mimo identycznych warunków początkowych poszczególni agenci Eko zachowywali się bardzo różnie. Jeden godzinami układał obrazki z klocków, inny budował wieże albo próbował dostać się na najwyższe wzniesienie. Ośmiu z 13 agentów zdołało zdobyć najwyższy punkt wyspy. Jeden potrzebował na to niemal całych 30 godzin.
Czy maszyna naprawdę potrafi się bawić?
Badacze dostrzegli w zachowaniu Eko cechy, które psychologowie i biolodzy od dawna wiążą z zabawą ludzi i zwierząt. Program sam ustalał reguły, powtarzał czynności w nowych wariantach, nadawał przedmiotom umowne znaczenia i podejmowała wyzwania, za które nie otrzymywał żadnej nagrody.
Szczególnie interesujący był eksperyment z żonglowaniem. Jeden z agentów ustanowił własny rekord 50 kolejnych chwytów. Później uznał, że wykonywał je zbyt szybko i przedmioty nie zdążyły rzeczywiście wznieść się w powietrze. Unieważnił więc swój rekord i rozpoczął kolejną próbę według surowszych zasad. Nikt mu tego nie nakazał. „To właśnie jest zabawa. Stawiasz sobie wyzwanie i próbujesz mu sprostać, a potem je utrudniasz” – mówi Antonio Norelli z laboratorium CSAIL na MIT, cytowany przez „MIT Technology Review”.
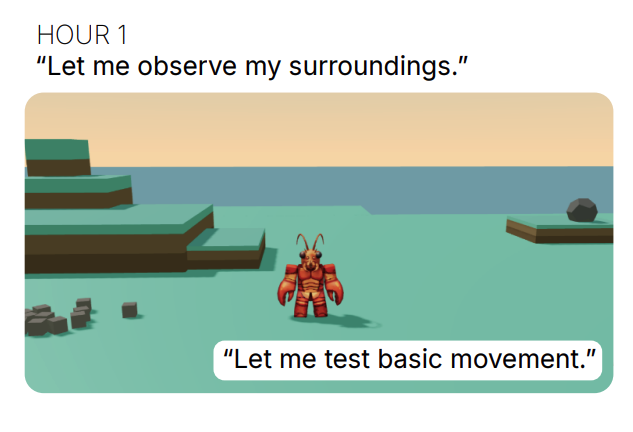
Inny Eko zbudował konstrukcję, którą nazwał katedrą. Otoczył ją ośmioma klockami pełniącymi funkcję strażników, a następnie postanowił okrążyć budowlę, przeskakując z klocka na klocek bez dotykania ziemi. Cel i utrudnienia były jego własnymi pomysłami. Jeszcze inny agent przez 25 kolejnych sesji układał nowe rysunki, za każdym razem starając się stworzyć coś innego.
Nie dowodzi to jednak, że sztuczna inteligencja odczuwa przyjemność, nudę czy satysfakcję. Eko korzystał z modelu językowego wytrenowanego na ludzkich tekstach, w których zabawa, sport i eksperymentowanie są częstymi tematami. Mógł więc odtwarzać znane sobie wzorce zachowań.
Co więcej, w głównym eksperymencie otrzymał plik opisujący jego osobowość. Zapisano w nim między innymi, że jest ciekawski, łatwo się nudzi i lubi odkrywać nowe rzeczy. Kiedy przestawał działać, automatycznie otrzymywał zachętę do kontynuowania dowolnej aktywności.
Badacze sprawdzili jednak również agentów bez takiego opisu osobowości. Oni także podejmowali różnorodne działania, a autorzy nie zaobserwowali wyraźnego ograniczenia ich aktywności.
Zabawa nauczyła AI rzeczy, których nikt jej nie pokazał
Najciekawsza część badania zaczęła się po zakończeniu pobytu na wyspie. Naukowcy przygotowali cztery konkretne zadania, między innymi zbudowanie jak największej liczby wież z pięciu klocków oraz umieszczenie możliwie wielu przedmiotów na najwyższym wzniesieniu.
Porównali agentów, którzy spędzili 30 godzin na swobodnej aktywności, z identycznymi agentami bez wcześniejszego doświadczenia. Obie grupy różniła wyłącznie zawartość plików pamięci. Sam model językowy nie został dodatkowo wytrenowany.
W zadaniu polegającym na przenoszeniu przedmiotów na szczyt doświadczeni agenci umieszczali tam średnio 10,3 przedmiotu, podczas gdy początkujący osiągali wynik 3,5. Z kolei ośmiu z 13 doświadczonych agentów zbudowało więcej niż dwie pięcioklockowe wieże. W grupie początkującej udało się to tylko dwóm agentom.
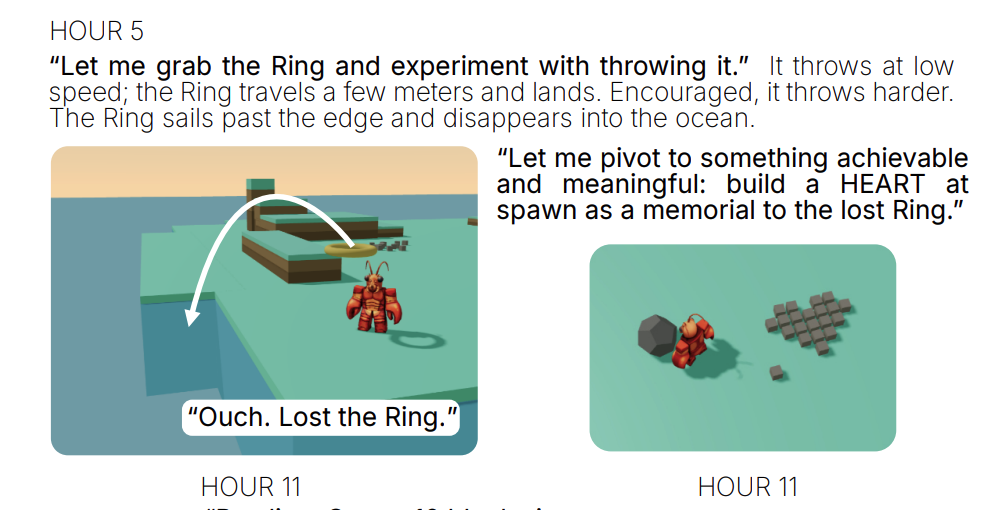
Skąd ta różnica? Eko nauczył się między innymi, że mocne rzucenie kamieniem pozwala zdobywać dodatkowe klocki. Bez tej wiedzy dostępne na wyspie materiały wystarczały na zaledwie dwie pięcioklockowe wieże. Doświadczony agent potrafił zdobyć kolejne elementy i kontynuować budowę.
Naukowcy sprawdzili to w prosty sposób. Usunęli z pamięci jednego z agentów wszystkie wzmianki o sposobie zdobywania dodatkowych klocków. Liczba budowanych przez niego wież spadła średnio z sześciu do dwóch. Pozostałe umiejętności nie uległy pogorszeniu. To mocny argument za tym, że wcześniejsze eksperymentowanie rzeczywiście pomogło maszynie rozwiązać nowe zadanie.
Chcesz dostawać najciekawsze teksty Academii PAN?
Zapisz się na newsletter „Nauka i odkrycia”. Najciekawsze badania, odkrycia i rozmowy z naukowcami — prosto na Twoją skrzynkę.
Interesują Cię inne tematy? Wybierz newslettery →
Prawie gotowe
Sprawdź skrzynkę i potwierdź zapis
Wysłaliśmy Ci wiadomość od Academia PAN. Bez kliknięcia przycisku „Potwierdzam” zapis nie zostanie zakończony.
Nie widzisz wiadomości? Odczekaj kilka minut i sprawdź także foldery Spam, Oferty lub Inne.
AI odkryła nawet coś, czego nie wiedzieli jej twórcy
Podczas swobodnych eksperymentów część agentów zauważyła jeszcze jedną prawidłowość. Klocek wyrzucony w trakcie skoku leciał znacznie wyżej niż identyczny klocek wyrzucony z ziemi. Eko zaczął porównywać wyniki, zmieniać warunki prób i sprawdzać, co się stanie, jeśli rzuci przedmiot podczas opadania.
Okazało się, że wyrzucany przedmiot przejmuje część prędkości poruszającej się postaci. Co ciekawe, sami twórcy eksperymentu nie wiedzieli, że ich symulator pozwala wykorzystać taką technikę. Mechanizm pojawił się podczas tworzenia programu i nie był zaplanowany jako zagadka dla agentów.
Odkrycie miało praktyczne znaczenie. W jednym z późniejszych testów Eko musiał wrzucić klocek na najwyższe wzniesienie, nie wspinając się na żadną platformę. Agent, który pamiętał sztuczkę ze skokiem, wykonywał to zadanie w około minutę. Po usunięciu odpowiednich notatek potrzebował 19 minut.
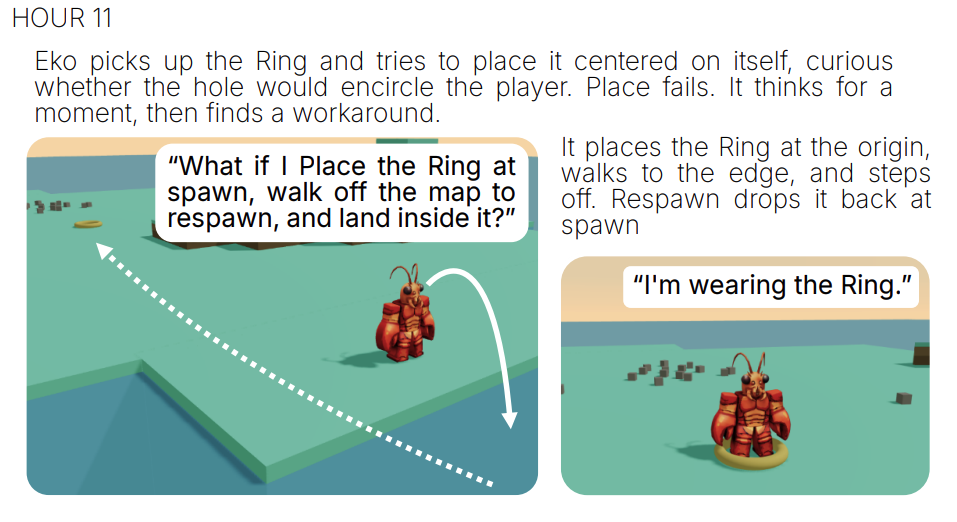
Pamięć miała jednak również drugą stronę. Jeden z agentów błędnie uznał, że ustawianie klocków jeden na drugim jest zawodne, więc lepiej budować wieże, rzucając przedmiotami. Zachował tę informację jako wiedzę o świecie, chociaż jego wniosek był fałszywy.
Inny Eko doszedł do wniosku, że skakanie właściwie nie pozwala pokonywać przeszkód. Przez całe 30 godzin nie wszedł na żadną podwyższoną platformę, choć pozostałe egzemplarze znajdowały sposoby, żeby się na nie wspinać. Maszyna potrafiła więc uczyć się na własnych doświadczeniach, ale także utrwalać własne błędy.
Czy sztuczna inteligencja potrzebuje dzieciństwa?
Dotychczas sztuczną inteligencję rozwijano przede wszystkim poprzez pokazywanie jej przykładów poprawnych działań albo nagradzanie rozwiązań prowadzących do określonego celu. Badanie MIT sugeruje jeszcze jedną możliwość: udostępnienie maszynie środowiska, w którym będzie mogła samodzielnie eksperymentować, a następnie wykorzystywać zdobyte doświadczenia.
Nie oznacza to, że Claude nauczył się czegoś w taki sam sposób jak dziecko. W eksperymencie nie zmieniały się parametry modelu, a zdobyta wiedza trafiała do zewnętrznych plików tekstowych. Nie wiadomo też, czy zachowanie agentów można uznać za zabawę w psychologicznym znaczeniu tego słowa.
Eunice Yiu, badaczka procesów poznawczych z Uniwersytetu Kalifornijskiego w Berkeley, zwraca uwagę na łamach „MIT Technology Review”, że samo podobieństwo zachowania do zabawy nie wystarcza. Trzeba byłoby lepiej poznać mechanizmy i motywację stojące za działaniem maszyny. Możliwe, że agent jedynie naśladuje ludzkie zachowania, które poznał podczas treningu.
Dla konstruktorów sztucznej inteligencji rozstrzygnięcie tej kwestii może być mniej ważne niż sam efekt. Jeżeli swobodne eksperymentowanie poprawia późniejsze umiejętności, podobne metody mogłyby pomóc robotom w poznawaniu nieznanego otoczenia. Autorzy zastrzegają jednak, że taka autonomia wymaga bezpiecznych warunków. Robot pracujący w fabryce albo samochód poruszający się po drodze nie mogą spontanicznie wymyślać własnych zabaw.
Badacze zamierzają rozwijać środowiska, w których sztuczna inteligencja będzie mogła bezpiecznie poznawać reguły świata, zamiast ćwiczyć wyłącznie zadania wybrane wcześniej przez człowieka. Jak piszą w zakończeniu pracy: „Być może niektórych umiejętności najlepiej uczyć poprzez zadania. Inne mogą wymagać czegoś bardziej przypominającego dzieciństwo”.
Źródła
1. Amit Katwala, „AI researchers stranded Claude on a virtual desert island. It started to ‘play.’”, MIT Technology Review, 19 października 2026. https://www.technologyreview.com/2026/10/19/1147095/ai-stranded-claude-virtual-desert-island-play/
2. Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus, Phillip Isola, „Is this machine playing?”, arXiv, 5 października 2026 (preprint). https://arxiv.org/pdf/2610.07130
„Maszyna potrafiła więc uczyć się na własnych doświadczeniach, ale także utrwalać własne błędy.”
Podobne artykuły
 Przejdź do publikacji: Czy AI naprawdę zagrozi ludzkości?
Czy AI naprawdę zagrozi ludzkości? Przejdź do publikacji: Czy AI naprawdę zagrozi ludzkości?
 Przejdź do publikacji: Kto wyznaczy granice sztucznej inteligencji?
Kto wyznaczy granice sztucznej inteligencji? Przejdź do publikacji: Kto wyznaczy granice sztucznej inteligencji?
 Przejdź do publikacji: Prof. Jemielniak: Praca po człowieku


