
Czytasz artykuł w trybie offline
Dlaczego żaden język nie ma słowa „niewszystkie”?


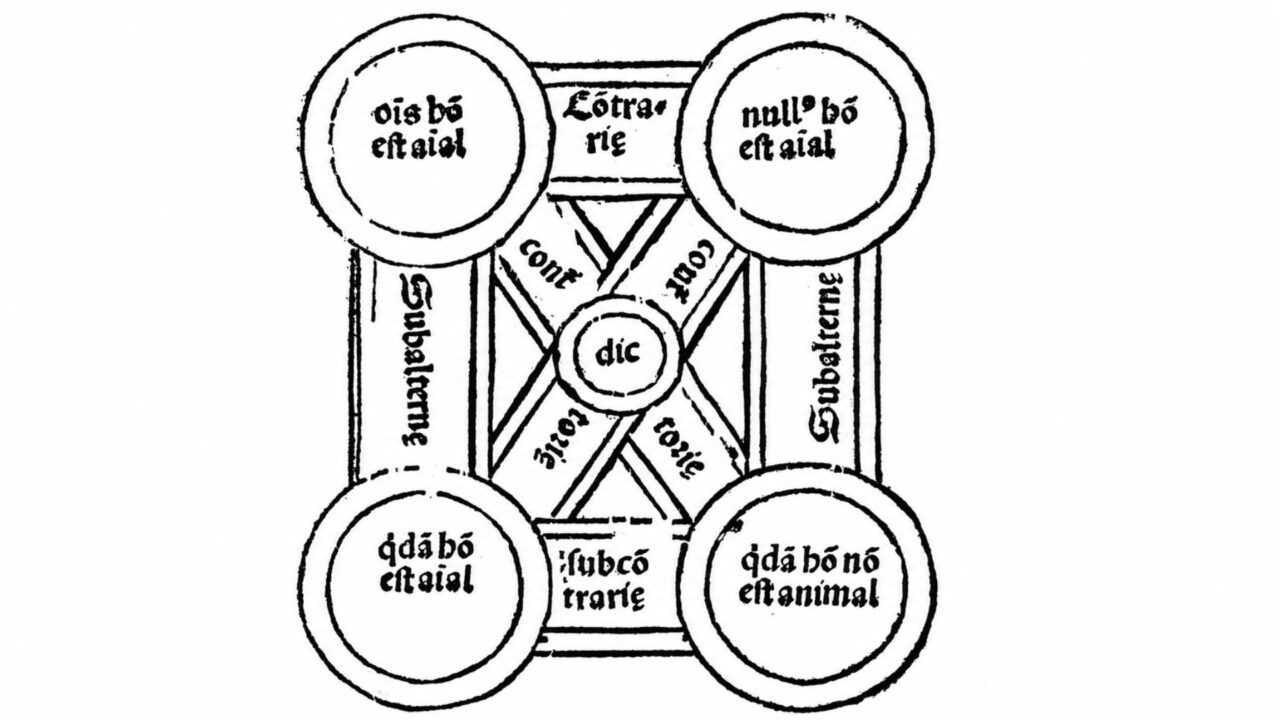
Kwadrat logiczny porządkował relacje między zdaniami już w dawnych podręcznikach. Dziś jego pozornie prosty układ pomaga stawiać pytania o granice ludzkiego języka. Ilustracja z „Margarita philosophica” Gregora Reischa, wydanie z 1517 r.; skan: Aristeas / Wikimedia Commons, domena publiczna.
Języki świata różnią się niemal pod każdym względem: brzmieniem, gramatyką, słownictwem. A jednak znaczenia, jakie niosą pojedyncze wyrazy, są do siebie zaskakująco podobne. Wiele pojęć, które łatwo sobie wyobrazić, nie ma jednak własnego słowa w żadnym znanym języku. Dlaczego? Odpowiedzi coraz częściej szukamy w obliczeniach, także w sieciach neuronowych
Już logicy średniowieczni porządkowali cztery podstawowe kwantyfikatory w tzw. kwadrat logiczny: „wszystkie”, „żaden”, „niektóre” oraz „niektóre nie”, czyli „nie wszystkie”. Trzy pierwsze mają w wielu językach własne, proste wyrazy. Czwarty – nie. Najwyraźniej widać to w angielskim. Trzy rogi kwadratu mają tam proste, niepodzielne słowa: „all”, „no” i „some”. Mówi się „not all”, ale nie ma słowa „nall”.
Nie jest to osobliwość języka angielskiego. Amerykański językoznawca Laurence Horn zwrócił uwagę, że ten róg kwadratu nie jest leksykalizowany w żadnym języku świata. Polski też nie ma prostego wyrazu na „nie wszystkie”. Podobnie jest ze spójnikami: mamy „i”, „lub”, a nawet „ani”, lecz nigdzie nie spotykamy prostego spójnika oznaczającego „nie i” (negacja koniunkcji).
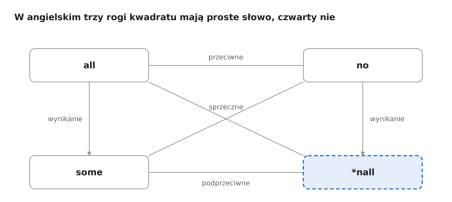
Logicznie nic nie stoi na przeszkodzie, by takie słowo istniało. „Nie wszystkie” jest pojęciem równie dobrym jak „żaden”. A jednak języki konsekwentnie z niego rezygnują.
Uniwersalia znaczeniowe
Luki w kwadracie to tylko jeden przykład tzw. uniwersaliów semantycznych (leksykalnych) – ograniczeń, które obowiązują we wszystkich językach świata. Dobrze zbadanym przykładem jest monotoniczność.
Aby wyjaśnić to pojęcie, porównajmy, jak działają kwantyfikatory „niektóry” i „żaden”. Jeśli „niektórzy studenci biegali szybko”, to z pewnością „niektórzy studenci biegali”. Jeśli „żaden student nie biegał”, to „żaden nie biegał szybko”. Oba te kwantyfikatory zachowują się więc przewidywalnie: zachowują prawdziwość, gdy zawężamy lub rozszerzamy to, o czym mówimy. Łatwo jednak wymyślić kwantyfikator, który się tak nie zachowuje, na przykład „dokładnie trzy”. To, że biegało dokładnie trzech studentów, nie implikuje, że dokładnie trzech studentów biegało szybko. Taką myśl da się wyrazić opisowo, ale żaden znany język nie ma na nią jednego słowa. Jon Barwise i Robin Cooper już w 1981 roku zaproponowali, że wszystkie proste kwantyfikatory w językach naturalnych są monotoniczne albo stanowią połączenie takich wyrażeń.
Podobne regularności widać poza kwantyfikatorami. Języki, na przykład, dzielą przestrzeń barw na różną liczbę nazw, ale niemal zawsze na spójne geometrycznie „wypukłe” obszary. Tutaj wypukłość jest pojęciem ze szkolnej geometrii. Figurę geometryczną nazywamy wypukłą, jeżeli dla każdych dwóch punktów należących do tej figury odcinek łączący te punkty w całości leży w jej wnętrzu. Jeśli dwa odcienie nazywamy tym samym wyrazem, to tym samym wyrazem nazywamy też odcienie leżące pomiędzy nimi. Żaden język nie ma słowa na oznaczenie koloru „jasnozielonego albo ciemnoczerwonego”, bo takie znaczenie nie byłoby wypukłe.
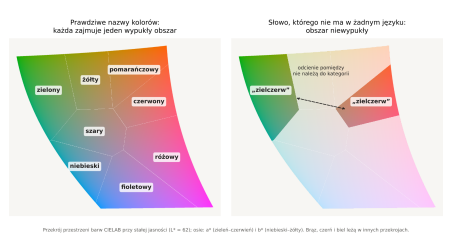
Przestrzeń możliwych znaczeń jest ogromna, a języki wykorzystują jej niewielki, specyficzny fragment. Pytanie brzmi: dlaczego właśnie ten?
Cztery potencjalne wyjaśnienia
W naukach o języku konkuruje kilka odpowiedzi.
- Wrodzone ograniczenia. Ludzki umysł ma wbudowane zasady, które z góry wykluczają pewne znaczenia (Gramatyka Uniwersalna Noama Chomsky’ego).
- Łatwość uczenia się. Niektóre znaczenia przyswaja się szybciej. Jeśli dzieci łatwiej uczą się słów monotonicznych, z czasem będą je preferować.
- Wydajność komunikacji. Słownik musi być jednocześnie prosty, czyli łatwy do zapamiętania, i informatywny, czyli pozwalający precyzyjnie wyrażać myśli. Charles Kemp i Terry Regier pokazali, że nazwy pokrewieństwa i kolorów w językach świata leżą blisko optymalnego punktu równowagi między tymi wymaganiami.
- Ewolucja kulturowa. Język przechodzi z pokolenia na pokolenie, a każda taka międzypokoleniowa kulturowa transmisja języka działa jak sito, które przepuszcza to, co łatwo zapamiętać i przekazać dalej.
Te wyjaśnienia nie wykluczają się wzajemnie. Kłopot w tym, że często przewidują to samo, więc trudno je rozróżnić samą obserwacją języków. Potrzebne są eksperymenty. I tu z pomocą przychodzi sztuczna inteligencja.
Sieć neuronowa jako obiekt doświadczalny
Możemy zbudować sztucznego ucznia, który nie ma żadnej wiedzy o języku, i sprawdzić, co przychodzi mu łatwiej. Wspólnie z Shane’em Steinert-Threlkeldem z Uniwersytetu Waszyngtonu uczyliśmy sieci neuronowe znaczeń różnych kwantyfikatorów. Część z nich występuje w językach, a część wymyśliliśmy tak, by „łamały” uniwersalia. Sieć oglądała proste sceny złożone z obiektów i miała ocenić, czy zdanie z danym kwantyfikatorem jest w nich prawdziwe.
Kwantyfikatory monotoniczne sieci przyswajały szybciej niż niemonotoniczne. Podobnie było z inną własnością: z tym, że znaczenie kwantyfikatora zależy tylko od liczby obiektów, a nie od ich położenia ani kolejności. Nie każda badana własność dała tak wyraźny efekt – i to również jest cenną informacją. Łatwość uczenia się może wyjaśniać niektóre uniwersalia, ale niekoniecznie wszystkie. W innej pracy uzyskaliśmy podobne wyniki w eksperymencie z ludźmi, którzy próbowali nauczyć się znaczeń nowych kwantyfikatorów. W kolejnych badaniach podobny wynik otrzymaliśmy dla nazw kolorów: sieci szybciej uczyły się kategorii wypukłych.
Do tego dochodzi miara prostoty niezależna od sieci. Kwantyfikatory spełniające uniwersalia mają też krótsze definicje w języku logiki – mówiąc obrazowo, potrzeba mniej instrukcji, by je opisać.
Ważne zastrzeżenie: sieć neuronowa nie jest modelem dziecka. Jest raczej narzędziem, które pozwala sprawdzić, czy dana własność znaczenia ułatwia naukę ogólnemu systemowi uczącemu się z przykładów, bez wrodzonej gramatyki. Jeśli tak, wyjaśnienie przez wrodzoność przestaje być jedynym kandydatem.
Języki, które uczą się same siebie
Drugi typ eksperymentu symuluje przekazywanie języka między pokoleniami. Pierwszy uczeń – człowiek albo sieć – poznaje sztuczny słownik, a potem uczy go następnego ucznia, ten kolejnego i tak dalej. Metodę tę, zwaną uczeniem iterowanym, rozwinął m.in. Simon Kirby z Uniwersytetu Edynburskiego.
Okazuje się, że nawet z początkowo przypadkowego zbioru znaczeń po wielu pokoleniach wyłania się uporządkowany system. W naszych symulacjach z kwantyfikatorami po wielu pokoleniach przeważały znaczenia monotoniczne, choć nikt ich nie zaprogramował. Drobne preferencje pojedynczego ucznia, powtarzane w długim łańcuchu przekazu, potrafią ukształtować cały język.
Co zostaje do wyjaśnienia
Mamy więc kilka wyjaśnień, a każde z nich ma za sobą jakieś dane. Najciekawsze pytanie nie brzmi już które z nich jest prawdziwe, lecz: które ograniczenie wymaga jakiego wyjaśnienia.
Być może luki w kwadracie logicznym nie są wrodzonym ograniczeniem ludzkiego języka, a wynikają z wydajności komunikacji. Skoro „niektóre” zwykle i tak sugeruje „nie wszystkie”, osobne słowo byłoby zbędne – tak argumentował Horn. Z drugiej strony, monotoniczność czy wypukłość zdają się wynikać z łatwości uczenia się czy ewolucji kulturowej. Ale wypukłość okazuje się również optymalnym rozwiązaniem do zrównoważenia prostoty i informatywności? A może to tylko korelacja i to właśnie “wypukłość” jest wrodzonym ograniczeniem? Badacze języka i umysłu zajmują się właśnie takimi pytaniami. Rozstrzygnięcie tych kwestii jest ważne ponieważ pozwoliłoby nam zrozumieć, ile struktury ludzkiego języka pochodzi z budowy umysłu, a ile z tego, że język jest narzędziem, którego się uczymy, używamy i które przekazujemy innym.
Tu sztuczna inteligencja okazuje się przydatna w nieoczekiwany sposób. Nie dlatego, że myśli jak człowiek. Raczej dlatego, że możemy jej używać do testowania różnych hipotez dotyczących np. procesu uczenia się lub międzypokoleniowej transmisji kultury.
Prof. Jakub Szymanik – lingwista, psycholog, kognitywista i logik z Uniwersytetu w Trydencie. Bada, m.in. dlaczego słowa w językach świata znaczą to, co znaczą, łącząc eksperymenty z ludźmi, logikę i modelowanie obliczeniowe, w tym sieci neuronowe.
Dla zainteresowanych
- S. Steinert-Threlkeld, J. Szymanik, Ease of learning explains semantic universals, Cognition 195 (2020).
- F. Carcassi, S. Steinert-Threlkeld, J. Szymanik, Monotone quantifiers emerge via iterated learning, Cognitive Science 45 (2021).
- I. van de Pol i in., Quantifiers satisfying semantic universals have shorter minimal description length, Cognition 232 (2023).
- Ramotowska i in. Adult learning of a novel quantifier tracks semantic universals. Cognition, 2026.
Chcesz dostawać najciekawsze teksty Academii PAN?
Zapisz się na newsletter „Nauka i odkrycia”. Najciekawsze badania, odkrycia i rozmowy z naukowcami — prosto na Twoją skrzynkę.
Interesują Cię inne tematy? Wybierz newslettery →
Prawie gotowe
Sprawdź skrzynkę i potwierdź zapis
Wysłaliśmy Ci wiadomość od Academia PAN. Bez kliknięcia przycisku „Potwierdzam” zapis nie zostanie zakończony.
Nie widzisz wiadomości? Odczekaj kilka minut i sprawdź także foldery Spam, Oferty lub Inne.
Drobne preferencje pojedynczego ucznia, powtarzane w długim łańcuchu przekazu, potrafią ukształtować cały język.
Podobne artykuły
 Przejdź do publikacji: Prof. Hansen i słowa, które zmieniają ludzi
Prof. Hansen i słowa, które zmieniają ludzi Przejdź do publikacji: Prof. Hansen i słowa, które zmieniają ludzi
 Przejdź do publikacji: Co się dzieje w mózgu, kiedy mamy słowo „na końcu języka”?
Co się dzieje w mózgu, kiedy mamy słowo „na końcu języka”? Przejdź do publikacji: Co się dzieje w mózgu, kiedy mamy słowo „na końcu języka”?
 Przejdź do publikacji: Czy duży model językowy może być świadomy?


